评测Agent的流程分析
系列:开源模型评测
来源公众号:智能大时代
发布时间:2026-09-01 22:14
原文链接:阅读公众号原文
本篇以 Harbor框架 为例分析一下 Agent 评测的流程。其他的 Agent 评估框架结构和流程类似。
Agent 评测有助于评价企业 Agent 是否安全、稳定运行,同时,有利于为企业降低 token 成本。
当前,企业 Agent 已经开始大量上生产,但 evaluation engineering 明显落后于 observability 和 Agent development,为企业构建评测架构变得非常重要。
Harbor 框架是当前主流的 Agent 评测框架,是 Terminal-Bench 2.0 的官方评测设施,也支持 SWE 等任务的评测,此外,workbuddy-bench 也是基于 Harbor 构建的。更多介绍:Harbor 介绍:面向 Agent 评测的基础设施
Harbor 的典型流程可以概括为:
确定评测场景 ↓ 设计 Task ↓ 构建 Environment ↓ 编写 Verifier ↓ Oracle 验证 ↓ 多个 Tasks 组织成 Dataset ↓ 接入 Agent / Model ↓ 运行 Job ↓ 分析结果 ↓ 优化模型或 Agent
还可以将 Harbor 产生的 Trajectory 和 Reward 收集起来,用于 SFT、Preference Training 或 RL,提升模型能力。
创建 Task
Harbor 中最基本的评测单位是 Task。
可以通过 CLI 初始化:
harbor task init office-calendar-001
典型 Task 包含:
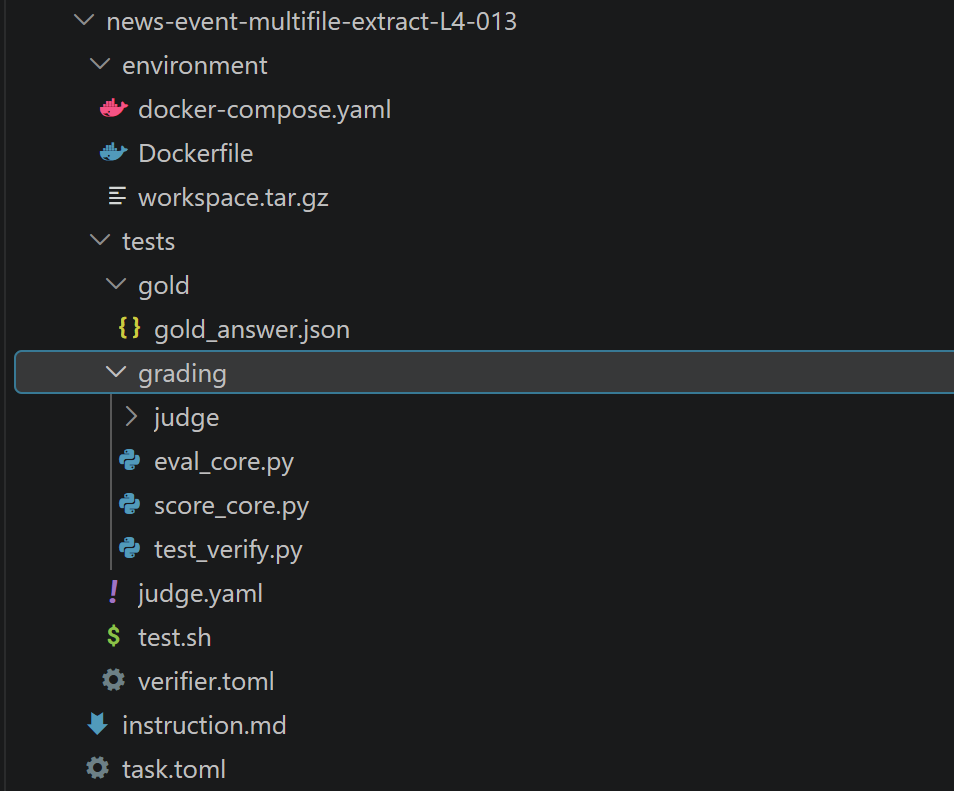
office-calendar-001/ ├── instruction.md ├── task.toml ├── environment/ ├── solution/ └── tests/
其中:
•
instruction.md描述 Agent 需要完成的任务;•
environment/定义执行环境和初始数据;•
tests/定义 Verifier;•
solution/保存标准解法,即 Oracle Solution;•
task.toml配置超时、网络、资源等参数。
例如在办公领域,一个企业办公任务可以是:
Alice 无法参加周五下午的会议。 请读取她最新的邮件,找到双方都有空的时间, 重新安排会议并通知 Alice。
对应的 Environment 可以包含邮件、日历、联系人以及模拟企业 API。现在提供真实环境模拟器已经成为一门生意,相关企业例如 Mechanize、Fleet。
使用 Oracle 验证 Task
Task 制作完成后,不建议立即交给待测模型,而应先使用 Oracle 执行:
harbor run \ -p office-calendar-001 \ -a oracle
运行上述命令后,Oracle 会按照 solution/ 中定义的标准方案完成任务。
需要说明:这里的 Oracle 指的是使用非大模型方法提供的解决方案,之所以使用 Oracle 运行,是为了保证环境和结果是正确的。
如果最终 Reward 符合预期,就可以说明:
Environment 可运行 Verifier 正确 Task 可以完成 Ground Truth 合理
从而可以避免把 Benchmark 本身的问题误判为模型能力问题。
组织 Dataset
多个 Task 可以组合成 Dataset,例如:
enterprise-office-bench/ ├── email/ ├── calendar/ ├── document/ ├── spreadsheet/ └── safety/
可以通过:
harbor dataset init "company/office-bench"
对于企业场景,不需要人工维护大量 Harbor Task。更合理的方式是程序化实现:
企业内部 Case ↓ 自定义 Case Schema ↓ Harbor Dataset Adapter ↓ 自动生成 Harbor Tasks
例如内部可以用 YAML 或 JSON 描述业务 Case,再由 Adapter 自动生成 Instruction、测试数据、Verifier 和 Task 配置。
接入 Agent 和模型
Dataset 准备完成后,需要指定待评测的 Agent 和 Model。
Harbor 支持多种 Agent,也允许接入企业自己的 Agent Runtime。
对于企业内部的微调模型,可以通过:
vLLM SGLang OpenAI-Compatible API
提供模型服务。
整体关系为:
Harbor ↓ Agent Runtime ↓ Fine-tuned Model ↓ Enterprise Tools / MCP
需要注意,实际应该评测的通常不是裸模型,而是最终准备上线的完整 Agent 系统:
Model + System Prompt + Tool Schema + Agent Logic + RAG + Guardrails
运行 Harbor Job
本地 Dataset 可以直接执行:
harbor run \ -p ./enterprise-office-bench \ -a company-office-agent \ -m company-office-14b
Harbor 会将 Dataset 展开为多个 Trial。
每个 Trial 的生命周期大致为:
启动 Sandbox ↓ 运行 Agent ↓ 调用工具并修改环境 ↓ Agent 完成任务 ↓ 执行 Verifier ↓ 生成 Reward ↓ 保存 Trajectory / Logs / Artifacts
如果有:
500 Tasks × 3 Attempts × 3 Models
最终就是 4500 个 Trial。
Harbor 支持 Job 内并发,也可以结合远程 Sandbox、Kubernetes 或 Slurm 将多个 Job 分布到不同服务器运行。
分析评测结果
Harbor 会保存 Job 和 Trial 的详细结果,包括:
Reward Agent Trajectory Tool Calls Verifier Logs Token Usage Latency Errors Artifacts
可以通过:
harbor view ./jobs
启动 Viewer。
因此分析时不仅可以得到:
模型成功率是多少?
还可以进一步定位:
是模型理解错误? 工具选择错误? 参数生成错误? Prompt 有问题? Agent Workflow 有问题? 还是 Verifier 本身有问题?
从 Eval 到模型优化
Harbor 最终产生的不只是一个 Benchmark 分数,还包括完整的 Trajectory 和 Reward。
这些数据可以继续用于:
1. 高 Reward Trajectory ↓ SFT 2. 同一 Task 的好坏对比 Rollout ↓ Preference Training 3. 当前模型多次 Rollout ↓ Verifier Reward ↓ GRPO / PPO
进一步可以形成模型迭代闭环:
Enterprise Dataset ↓ Harbor Rollout ↓ Trajectory + Reward │ ├── Evaluation ├── Failure Analysis ├── SFT └── RL ↓ Better Model ↓ 重新运行 Harbor
需要注意,Harbor 负责 Environment、Rollout 和 Reward(训练数据收集),模型后训练则由专门的后训练框架完成。
企业落地建议
企业如果想使用 Harbor 进行 Agent 评测,例如测试小模型能力,可以分三步实施。
第一步先建设小规模高质量 Benchmark:
真实业务 Case ↓ 脱敏 / 合成 ↓ 50~100 个 Harbor Task ↓ Oracle 验证
benchmark构建格式可以参考 workbuddy-bench:https://github.com/Tencent/workbuddy-bench
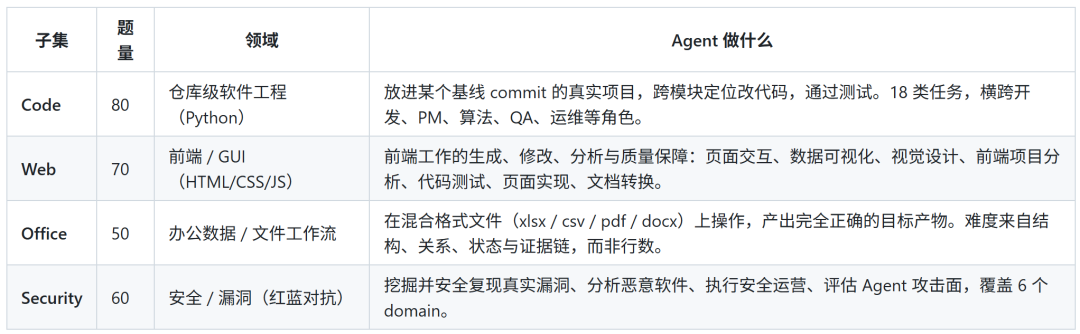
Workbuddy-Bench 现在提供四类场景的bench,可以下载后查看各类场景的task结构、judge定义方法,类似下图
第二步同时测试 Base Model、微调小模型和强大模型,得到模型能力边界,例如:
邮件分类 → 小模型 信息抽取 → 小模型 简单工具操作 → 小模型 复杂跨文档推理 → 大模型 多工具长链路任务 → 大模型 高风险任务 → 人工确认
第三步将生产环境中的失败 Case 持续加入 Harbor Dataset,形成 Regression Benchmark,并进一步将高质量 Trajectory 用于 SFT 或 RL。
最终形成:
生产 Case ↓ Harbor Dataset ↓ 持续 Evaluation ↓ 模型 / Agent 优化 ↓ SFT / RL ↓ 新模型 ↓ 重新 Evaluation
在这个过程中,对多个模型的能力测试数据,后续也可以用于模型路由,训练路由模型。现在很多人关注模型路由,模型得以科学路由的基础,是对各模型能力的客观评估。