前一篇(企业智能体的可信查询问题 ),我们讲了企业智能体可信查询的重要性。
当前火热的OpenClaw、Hermes等智能体,更适合作为个人助理,其中的记忆方案,是不精确、模糊的,虽然从使用层面可以看到一定的记忆效果,但是哪怕用于个人办公,都不能保证提供准确的信息,比如用户问一个增长率的数据,智能体使用的增长率是不是你内心中想的那个增长率,计算方式是谁定的,什么时候落到记忆里的,记录是否准确,是否有失效期,是否覆盖过之前的增长率定义。这些问题,即便结合飞书等知识平台,也很难得到缓解。
相关的问题,还有诸如:
AI 到底该相信哪些数据? 这些数据是什么意思? 指标口径是否统一? 查询是否受控? 答案能不能解释、追溯、审计?
如果这些问题没有解决,上层的智能体应用很容易变成“看起来很聪明,实际上不可靠”。企业生产使用的智能体,例如智能问数、RAG、算法决策,如果想要获取可信数据,进而可信执行,必须基于企业的可信查询层(可信数据基础设施)。
基于对这个问题的理解,我们做了框架思考和落地实践,例如可信问数。
过去2个多月,我们开发了一套基于可信语义层的智能问数,语义层使用的是cube框架,cube(cube core)只提供headless的核心实现,我们打造了前端的功能映射、管理配置和查询系统,这个过程中消耗了一百多亿的token。
不过也须知,cube解决的是语义层的查询问题,针对的是结构化数据,可以解决统一口径的数据查询,无法彻底解决数据本身的可信问题;此外,问数场景之外的其他智能应用,如果要可信查询,也需要分别有一套可信基础,这个基础,对于不同的智能体来说,应该是通用的,对于企业来说,可以理解为企业物理世界的数字映射,例如Palantir的系统。
现在常见的本体+知识图谱,解决的也是这个问题,相关的实现方案很多,各有千秋。下面我们以 DataHub 为例,结合 Cube ,给出我们对于企业可信数据基础设施应该怎么考虑,以及流程是怎么样的理解。
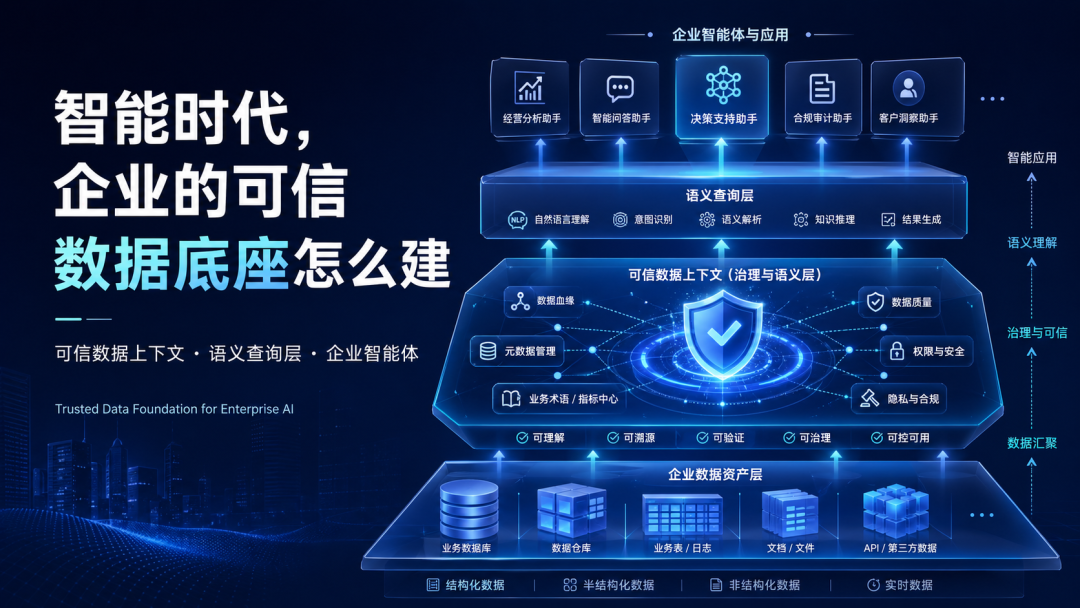
首先讲一下 DataHub 和 Cube分别的定位是什么,解决的什么问题。
DataHub 解决的是:可信数据上下文如何沉淀和治理。
它关注的是:
- 企业有哪些数据资产;
- 这些数据资产是什么意思;
- 谁负责这些数据;
- 数据从哪里来、流向哪里;
- 有没有血缘;
- 有没有质量问题;
- 哪些表是权威表;
- 哪些字段是敏感字段;
- 哪些业务术语是官方定义。
所以 DataHub 更像是企业的数据资产地图和可信上下文层。
而 Cube 解决的是:怎么按统一口径查数据。
它关注的是:
- 指标怎么定义;
- 维度怎么定义;
- 表之间怎么 join;
- 用户能查哪些数据;
- 查询如何通过 API 暴露;
- 高频查询如何加速;
- LLM 或应用如何安全地访问指标。
所以 Cube 更像是智能问数的语义查询层。
一句话区分:
DataHub 管“该信谁”,Cube 管“怎么查对”。
为什么智能问数不能只靠 LLM 直接查数据库?
很多智能问数系统最开始都会走一条看似简单的路:
用户自然语言问题 → LLM + 检索上下文 生成 SQL → 查询数据库 → 返回结果
这个方式做 Demo 很快,但一进入企业真实(复杂)环境,问题会非常多。
比如:
同一个“销售额”,不同部门可能有不同口径。 一张订单表里可能有支付金额、下单金额、退款金额、优惠金额。 用户问“华东区”,可能指销售大区,也可能指客户注册地,也可能指门店所在地。 有些字段虽然存在,但已经废弃。 有些数据虽然能查,但这个用户没有权限看。 有些表虽然名字像正式表,其实只是临时表或中间表。
这时,如果让 LLM 直接面对数据库,它很容易:
- 选错表;
- 用错字段;
- join 错路径;
- 算错指标;
- 绕过权限;
- 返回无法解释的结果。
有没有可能使用skill之类的技术通过用户使用过程持续进化问数系统呢,skill只是工作流程,skill 或工作流可以沉淀常见分析步骤、澄清流程和工具调用方式,但它不能替代指标口径、业务术语、权限、血缘和质量状态这些强治理对象。换句话说,skill 可以作为上层编排资产,但它依然需要依赖一个可精确表示、可审计、可治理的可信数据层。
所以企业级智能问数的重点不是“让模型更会写 SQL”,而是:
让模型只能在可信、受治理、可解释的数据语义范围内工作。
这就是 DataHub + Cube 组合的价值。
DataHub 在智能问数里起什么作用?
DataHub 可以理解为企业数据资产的“可信上下文中心”。
它不是用来直接算指标的,而是用来帮助智能系统理解:
企业里有哪些数据,哪些数据可信,这些数据分别是什么意思。
在智能问数中,DataHub 可以提供几类关键上下文。
数据资产上下文
比如企业里有很多表:
ods_order dwd_order_detail ads_sales_summary tmp_order_2024 finance_revenue_monthly
业务用户问“销售额”,系统不能随便挑一张表。
DataHub 可以帮助识别:
- 哪些表是正式生产表;
- 哪些表属于销售域;
- 哪些表已经废弃;
- 哪些表是下游报表正在使用的权威表;
- 哪些表有 owner 和说明。
这让智能系统知道:哪些数据可以优先相信。
业务术语上下文
智能问数最难的不是字段映射,而是业务术语映射。
例如:
- GMV;
- 净收入;
- 活跃用户;
- 复购率;
- 高价值客户;
- 有效订单;
- 履约订单。
这些词对业务很自然,但对数据库来说并不天然存在。
DataHub 的 Business Glossary 可以把这些术语沉淀下来,并绑定到对应的数据资产、字段、指标和负责人。如果企业把 Cube 指标、BI 指标或自定义 Metric 实体同步进 DataHub,业务术语还可以进一步关联到具体指标对象。
这样,当用户问“高价值客户复购率”时,系统可以先知道:
- 什么是高价值客户;
- 什么是复购率;
- 这些概念属于哪个业务域;
- 对应哪些数据资产;
- 是否有官方定义。
血缘和影响分析
智能问数不仅要能回答,还要能解释。
比如用户问:
“这个销售额来自哪里?”
系统应该能回答:
该指标来自销售经营数据产品, 底层依赖订单事实表、支付明细表和客户维度表, 上游数据由交易系统同步, 下游被经营看板和月度分析报表使用。
这就需要血缘。
DataHub 可以记录数据从上游系统到中间表、指标表、报表、看板的流动关系。 这对可信问数很重要,因为企业用户往往不只是要一个数字,还要知道这个数字从哪里来、能不能信、影响哪些下游应用。
Owner、标签和质量状态
智能问数系统还应该知道:
- 这张表谁负责;
- 这个指标谁维护;
- 这个字段是否包含敏感信息;
- 这个数据最近是否更新;
- 有没有质量异常;
- 这个资产是否被认证。
这些信息不适合放在 LLM prompt 里临时拼,而应该沉淀在 DataHub 这样的元数据治理平台里。
因此,DataHub 在智能问数中的价值可以概括为:
让 Agent 在查询前,先理解企业数据资产的可信上下文。
Cube 在智能问数里起什么作用?
如果说 DataHub 告诉系统“该用什么可信数据”,那么 Cube 负责把这些数据变成“可查询、可控制、可复用的业务语义”。
Cube 的核心是语义层。
它会把底层数据库里的表和字段,封装成业务可以理解的对象:
底层字段: orders.pay_amount orders.created_at customers.region customers.customer_level Cube 语义层: 销售额 订单数 客户数 复购率 区域 客户等级 下单时间
这样,智能问数系统就不需要让 LLM 直接拼复杂 SQL,而是让 LLM 调用 Cube 中已经定义好的指标、维度和过滤条件。
统一指标口径
比如“销售额”应该怎么算?
是订单金额? 是支付金额? 是否扣退款? 是否扣优惠? 是否含税? 是否只算已支付订单?
这些口径不能交给 LLM 临时判断,而应该在 Cube 语义层中明确沉淀。
一旦 Cube 中定义了标准指标,所有上层应用都通过同一个指标访问:
智能问数 BI 看板 嵌入式分析 Agent 算法验证平台
它们拿到的就是同一套口径。
控制 join 路径
企业数据库中最容易出错的地方之一就是 join。
订单表可以关联客户表、商品表、门店表、渠道表、活动表。 如果 join 粒度不对,很容易把数放大或算错。
Cube 可以在语义层里预先定义好哪些表怎么关联,避免 LLM 自己猜 join 路径。
这对智能问数非常关键。
控制权限
智能问数系统如果直接查数据库,很容易带来权限风险。
比如:
- 区域经理只能看自己区域;
- 门店店长只能看自己门店;
- 财务数据只有财务可见;
- 客户手机号、身份证号、地址等字段不能暴露给普通用户。
Cube 可以结合访问策略、行级权限、用户上下文来控制查询范围。
原则上,企业级智能问数应该做到:
Agent 不能绕过 Cube 直接查原始库。
所有查询都应该走受控语义层。
提供稳定 API
Cube 提供 API,让智能问数系统可以用结构化方式调用指标和维度。
这比让 LLM 直接生成 SQL 更稳定。
理想状态下,LLM 输出的不是:
select ...
而是类似:
{ "measure": "Sales.revenue", "dimensions": ["Region.name"], "filters": { "Region.name": "华东" }, "time_range": "last_month" }
然后由 Cube 根据语义层生成并执行真正的查询。
这样,LLM 负责理解和编排,Cube 负责执行和治理。
DataHub 和 Cube 应该如何配合?
DataHub 和 Cube 可以这样配合:
用户问题 ↓ 智能问数 Agent ↓ 先查 DataHub:理解术语、数据资产、血缘、质量、owner ↓ 再查 Cube:调用统一指标、维度和权限模型 ↓ 数据库 / 数仓 ↓ 返回结果 + 口径 + 来源 + 可信说明
也就是说:
DataHub 是查询前的可信上下文层 Cube 是查询时的语义执行层
一个完整的智能问数流程示例
假设用户问:
“上个月华东区高价值客户的复购率下降了吗?”
一个可信智能问数系统不应该立刻生成 SQL,而应该按下面流程走。
第一步:Agent 理解问题
系统先拆解问题:
指标:复购率 对象:高价值客户 区域:华东区 时间:上个月 分析意图:是否下降
第二步:查询 DataHub
系统去 DataHub 中查:
- “复购率”的官方定义是什么;
- “高价值客户”的定义是什么;
- “华东区”指哪个业务区域口径;
- 哪些数据产品和这些术语相关;
- 相关表是否被认证;
- 数据最近是否有质量异常;
- owner 是谁;
- 是否有历史查询样例。
如果发现歧义,系统应该先澄清:
“你这里的华东区,是指销售大区华东,还是客户注册地华东?”
第三步:选择 Cube 语义对象
系统根据 DataHub 返回的上下文,选择 Cube 中对应的指标和维度:
measure:Customer.repurchase_rate dimension:Customer.region filter:region = 华东 filter:customer_segment = 高价值客户 time:上个月
第四步:Cube 执行查询
Cube 根据已经定义好的语义模型:
- 使用统一复购率口径;
- 使用正确的事实表和维表;
- 走受控 join;
- 应用用户权限;
- 执行查询;
- 返回结果。
第五步:Agent 生成可信回答
最终答案不应该只是一句话:
“下降了。”
而应该是:
上个月华东区高价值客户复购率为 23.6%, 较上上个月下降 2.1 个百分点。 口径说明: 复购率 = 当期发生二次及以上购买的客户数 / 当期购买客户数。 数据来源: 客户经营数据产品,底层依赖订单事实表和客户维度表。 治理信息: 该指标由客户经营团队维护,相关数据资产为 certified。 本次查询未发现数据质量异常。 说明: 华东区按销售大区口径统计。
这才是可信智能问数。
几个治理原则
如果企业真的想把 DataHub + Cube 做成可信基础层,需要建立一些硬规则。
未认证数据不进入智能问数
生产问数默认只使用已进入 DataHub、已标记 owner、未废弃、具备认证或明确可信等级的数据。
默认规则应该是:
未进入 DataHub 的数据,不允许进入智能问数。 未标记 owner 的数据,不进入生产问数。 未认证的数据,不作为默认答案来源。 已废弃数据,不允许被 Agent 使用。
核心指标进入 Cube
核心指标不要散落在 提示词、代码、SQL、报表、Excel里。
应该统一沉淀到 Cube 语义层中,成为可复用、可治理的指标对象。
Agent 不直接查原始库
Agent 可以理解问题、调用工具、生成解释。
但真正查数应该走 Cube。
这样可以避免权限绕过、口径漂移和 SQL 幻觉。
答案可解释
可信问数的答案至少应该能解释:
- 指标口径;
- 数据来源;
- 时间范围;
- 过滤条件;
- owner;
- 数据质量状态;
- 是否有口径限制。
这也是 DataHub 和 Cube 一起使用的核心价值。
DataHub + Cube 不只是为了智能问数
这个组合的价值不止在 ChatBI,它还可以服务于更多智能应用。
对 RAG
DataHub 可以告诉 RAG 系统哪些文档、报表、数据产品更可信。 Cube 可以提供结构化指标结果。 这样 RAG 不只是回答文档问题,也能结合真实业务数据。
对算法快速验证
算法 Agent 可以先用 DataHub 判断:
- 数据是否存在;
- 数据粒度是否合适;
- 是否有历史数据;
- 质量是否正常;
- owner 是谁。
再用 Cube 获取可信指标和聚合特征,形成算法验证数据。
对企业本体网络
未来如果企业建设业务本体或知识图谱,DataHub 可以提供数据资产映射,Cube 可以提供指标和查询能力。
例如:
业务本体:客户、订单、商品、门店、仓库 DataHub:这些实体对应哪些表和字段 Cube:这些实体上的指标怎么计算
需要说明:这套系统如果要运行起来,确实有一定门槛,前期需要针对场景进行调研、测试,上线之后还需要持续维护,而且维护本身是有工作量的,所以应该优先选择高价值的核心场景。