Harbor 介绍:面向 Agent 评测的基础设施
系列:开源模型评测
来源公众号:智能大时代
发布时间:2026-08-31 21:42
原文链接:阅读公众号原文
今天介绍一个主流的,用于评测 Agent 能力的框架:Harbor。
Harbor 是2025年11月份和 Terminal-Bench 2.0 一起发布的,并服务于 Terminal-Bench。
为什么介绍这个评测框架呢?现在前沿模型的能力很强了,但是,很多办公场景其实不需要这么强的能力,如果可以使用小点的模型,可以节省企业不少成本,尤其如果企业有安全需求,需要本地部署模型的时候,模型的大小直接可以导致数倍甚至数量级的硬件成本差距。
此外,对于企业购买的智能体,能不能满足业务场景需求,中间的执行过程是否安全可靠,如何评测呢,也可以使用这个框架。
在开始之前,需要说明,这个框架不是以传统 Chatbot 的单轮问答评测为主要目标,而是专门用于评测可以直接做事的智能体的。
下面开始正式介绍 Harbor 。
随着大模型能力从文本问答逐步扩展到 Coding Agent、办公 Agent 和多工具 Agent,传统以“Prompt → Response → 打分”为核心的模型评测方式已经难以覆盖真实 Agent 场景。
实际的企业 Agent 往往需要读取文件、调用 API、操作数据库、访问知识库或办公系统,并经过多轮工具调用才能完成任务。因此,真正需要评估的不只是模型最终回答是否正确,而是:
• 是否选择了正确的工具;
• 是否按照正确顺序完成操作;
• 工具参数是否准确;
• 最终系统状态是否符合预期;
• 是否发生越权、误操作或敏感信息泄露;
• 整个执行过程是否稳定、可复现。
Harbor 正是在这一背景下产生的。
Harbor 来源于 Terminal-Bench 团队。Terminal-Bench 最初用于评估 Agent 在真实 Terminal 环境中的任务执行能力。随着原有 Benchmark Harness 被越来越多地用于自定义 Eval、Prompt Optimization、SFT 数据生成、RL Rollout 和 CI/CD Agent 测试,团队将其重新设计并独立成 Harbor。
因此,Harbor 的定位不是 Agent 开发框架,而是:
面向 Agent 的评测、实验和优化基础设施。
可以将其理解为:
Agent Evaluation Runtime + Sandbox Orchestrator + Benchmark Harness + Reward/Trajectory Infrastructure。
Harbor 的核心工作方式
Harbor 主要围绕以下几个核心对象组织:
• Task:一个具体任务,包括任务描述、运行环境和验证规则;
• Dataset:由多个 Task 组成的 Benchmark;
• Agent:执行任务的 Agent,可以是 Claude Code、Codex、自研 Agent 等;
• Environment:Agent 操作的隔离环境,通常基于 Docker 或远程 Sandbox;
• Verifier:检查任务最终结果,并输出 Reward;
• Trial:某个 Agent 执行某个 Task 的一次完整尝试;
• Job:由大量 Trial 组成的一次评测实验。
典型执行过程为:
Task ↓ 启动 Sandbox ↓ Agent 执行任务 ↓ 调用工具 / 修改环境 ↓ Verifier 验证结果 ↓ Reward + Trajectory + Logs
与传统 LLM Eval 最大的区别是,Harbor 评测的不是单纯的文本回答,而是 Agent 在真实或模拟环境中完成任务后的最终状态和完整执行过程。
Harbor 的主要能力
可执行的 Benchmark
Harbor 的 Task 不只是 Prompt,还包含 Docker 环境、文件、数据库、测试程序和模拟服务。
因此可以构造非常接近真实业务的评测,例如:
收到供应商延期邮件 → 查询项目状态 → 更新交付日期 → 起草通知邮件 → Verifier 检查所有操作是否正确
这非常适合办公 Agent、Coding Agent、数据分析 Agent 和企业 Workflow Agent。
Agent 与模型解耦
同一套 Dataset 可以运行不同 Agent 和模型,例如:
企业办公 Benchmark │ ├─ 微调 7B 模型 ├─ 微调 14B 模型 ├─ 大模型 API └─ 不同 Agent Scaffold
因此可以比较“小模型是否已经能够承担某类企业工作”,而不是只看通用 Benchmark 分数。
自动化 Verifier 与 Reward
Verifier 可以使用测试脚本、文件检查、数据库查询、业务规则或 LLM Judge 进行评分。
例如可以分别评价:
任务完成度 事实准确性 工具调用正确性 权限合规性 操作安全性 输出质量
对于企业场景,尤其可以把“禁止越权访问”、“不可未经确认执行危险操作”等规则做成硬性验证条件。
Sandbox 隔离
Harbor 默认可以使用 Docker,同时支持多种远程 Sandbox Backend。
Agent 和 Verifier 还可以运行在不同环境中,使 Agent 无法看到 Hidden Tests、Ground Truth 和内部评分规则。
对于企业 Benchmark,这种隔离方式有利于减少数据泄漏和 Reward Hacking。
结果与执行轨迹
Harbor 会保存每个 Trial 的:
Reward Agent Log Tool Calls Trajectory Token Usage 执行时间 错误信息 Artifacts
并提供 Viewer 用于分析失败任务。
因此不仅能够回答“成功率是多少”,还可以进一步分析:
为什么失败、在哪一步失败、是不是调用了错误工具,以及不同模型之间的能力差异。
Harbor 与现有技术栈的关系
Harbor 不替代 Agent Framework。
例如 LangGraph 负责:
Planner Memory Tool Routing Workflow
Harbor 则运行在其外层:
Harbor │ Task / Environment │ 自研 Agent / LangGraph │ Tools │ Verifier
Harbor 也不是 Post-Training Framework,但它可以产生 SFT 和 RL 需要的数据。参考:强化学习概述
部署与工程化特点
Harbor 是 Apache-2.0 开源项目,可以完全在企业内部运行。
典型企业架构可以是:
Internal Git ↓ Harbor Dataset ↓ Harbor Runner ↓ Docker / Kubernetes ↓ 内部 vLLM / SGLang ↓ 企业 Mock Service / MCP ↓ Verifier
Dataset、模型、评测结果和业务数据均可以保留在内网,不要求使用 Harbor Hosted 平台。
Harbor 同时采用 CLI-first 的设计,适合与 Git、CI/CD、Kubernetes、Slurm 等现有基础设施结合。
选型判断
Harbor 适合以下场景:
• Agent 需要真实调用工具或操作环境;
• 希望构建企业内部 Benchmark;
• 需要比较多个模型或 Agent;
• 需要进行 Agent 回归测试;
• 需要严格验证权限、安全和业务规则;
• 后续希望利用高质量 Trajectory 进行 SFT 或 RL。
如果只是做文本分类、摘要、NER 或简单问答评测,Harbor 相对偏重,普通 LLM Eval Framework 即可满足需求。
结语
Harbor 的核心价值是提供一套统一的 Agent Task、Sandbox、Rollout、Verifier 和 Reward 基础设施。
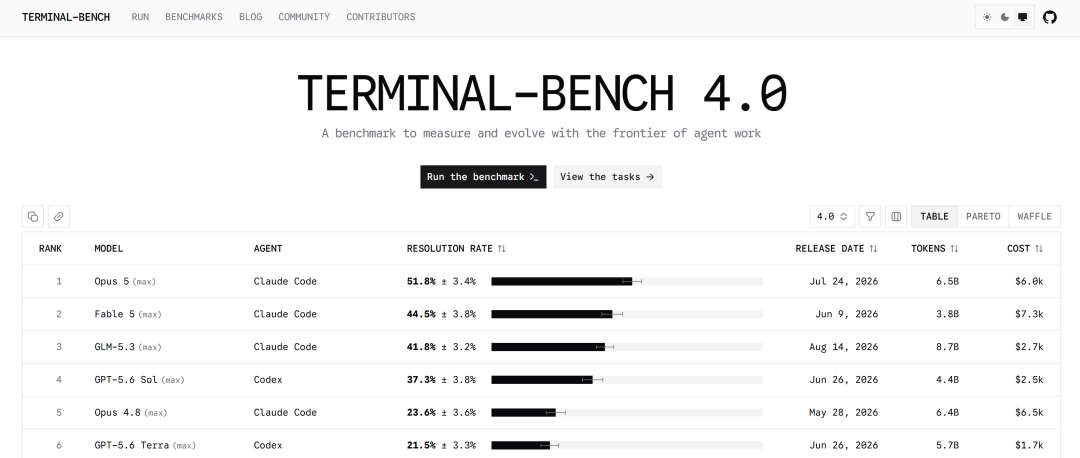
对于企业内部办公 Agent 和微调小模型评测,Harbor 可以将“模型到底能不能完成真实工作”转化成可执行、可验证、可重复运行的工程流程。
更重要的是,同一套 Task Infrastructure 后续还可以继续用于:
模型评测 → Agent Regression → 高质量 Trajectory 采集 → SFT → RL Rollout → 模型持续优化
如果企业计划长期建设自己的 Agent Benchmark、模型路由体系以及后续 SFT/RL 闭环,Harbor 是一个值得重点关注的选项。