AI时代的高质量数据集
系列:开源模型评测
来源公众号:智能大时代
发布时间:2026-08-28 08:39
原文链接:阅读公众号原文
高质量数据集是决定企业智能体效果的关键因素。本篇文章聊一聊如何为 AI 构建高质量数据集。
在传统机器学习时期,数据质量决定模型能力已经是一个共识。在传统机器学习中,通常的流程是:
数据 → 人工标注 → 特征工程 → ML 模型
在这个时期,“高质量”主要指标签准确、样本具有代表性、类别均衡、没有数据泄漏、异常值和缺失值处理合理,以及训练集/测试集分布合理。这类概念可以在任何机器学习相关的书籍中看到,例如周志华的《机器学习》。
最典型的例子是 ImageNet。2009 年的 ImageNet 论文就已经强调,大规模视觉学习不仅需要“更多图片”,还必须得到 cleanly annotated images;当时其公开规模已经达到约 320 万张图片。后来随着 2012 年 AlexNet 在 ImageNet 大赛上的突破,深度学习开始大规模进入计算机视觉领域。
深度学习开始之后,模型规模变得越来越大,因而也需要更多高质量的数据。例如训练一个模型可能需要数以千万甚至数亿计的样本,完全依靠人工标注的成本已经越来越难以承受。借助模型本身的能力,此时的高质量数据集开始出现类似“自举”的迭代流程:用一代模型为大量未标注数据生成监督信号,从而训练下一代模型。
比如 2020 年 Google 的 Noisy Student:
人工标注 ImageNet → teacher EfficientNet → 给 3 亿张未标注图片生成 pseudo labels → 训练 student EfficientNet
在这个过程中,teacher 模型相当于一个启发者,为海量未标注数据提供大致正确的监督信号,训练出下一代更强的 student 模型。
到了 LLM 时代,模型规模和训练计算量进一步快速增长。以 GPT-3 为例,2020 年参数规模已经达到 1750 亿。随着模型规模持续增长,与之相适配的高质量数据集也变得越来越重要。
2022 年 DeepMind 的 Chinchilla 工作证明,在固定计算量下,只增加参数而不给足训练数据并不是最优解;模型参数量和训练 token 数应当共同增长。Chinchilla 的重要意义之一,就是把“训练多少数据”从经验问题进一步提升成了 scaling law 中的核心变量。
同时也出现了很多关于数据质量如何影响模型能力的研究。比如 DataComp-LM 项目,就是要求“模型和训练代码固定,参赛者主要改数据”,它提供 240T token 的候选池,让研究者比赛谁的数据过滤、去重、混合策略更好。
与以往的机器学习比赛相比:以前比赛“谁的模型架构更好”;现在甚至可以直接比赛“谁喂的数据更好”。
这个时期的模型训练用到了大规模的互联网数据。针对这些数据的整理,一种典型的数据处理流程是:
海量原始数据
→ 大模型判断/评分/改写/标注
→ 高质量评分数据
→ 训练一个低成本的小分类器
→ 小分类器处理万亿级数据
→ 高质量预训练数据集
→ 训练新的大模型
随着互联网公开数据被越来越充分地利用,高质量、低重复、未污染的人类数据逐渐成为稀缺资源和模型继续扩展的瓶颈之一,因此业界也开始大量探索 synthetic data、数据重写以及模型生成训练数据。
与此同时,在另一个方向,知识蒸馏和 synthetic data 也大量采用类似的 teacher-student 范式:让一个更强的大模型生成某个领域的答案、解释或者大量领域样本,再去训练一个参数量小得多的专用模型。
随着智能体的大规模落地,高质量数据的需求开始从以往主要由模型厂商搜集、处理和维护,逐渐向企业内部扩展。
比如一个企业要真正落地 Agent,需要保证 Agent 的能力可靠,也需要保证它完成任务的过程符合业务要求。
需要说明的是,这里讲的 Agent,主要指能够根据任务状态自主规划、动态选择工具并执行多步操作的 agentic system,而不是所有步骤都预先编排好的固定 Workflow。
实际企业系统中,两者往往会结合使用:对于高确定性、步骤固定、强合规或者高风险的任务,可以更多使用 Workflow;而对于长尾、开放式、需要动态选择工具和处理不确定情况的任务,则更适合使用 Agent。
很多时候,企业最终采用的架构可能是:
Workflow outside,Agent inside;
或者:
Agent decides,Workflow executes。
那么,企业 Agent 需要什么样的高质量数据呢?
除了 Eval 数据,还有一类很重要的数据:Agent trajectory。
所谓 Agent trajectory,就是 Agent 在完成一个任务过程中实际执行了哪些动作,包括工具调用、调用参数、环境返回结果、状态变化以及最终执行结果。
这里说的 trajectory,主要指可观察、可记录的执行轨迹,并不要求获得模型内部不可见的推理过程。
有些人可能有疑问:模型不是能完成任务就可以吗,为什么还需要管它怎么做?
主要有几个原因。
第一,通过 trajectory,可以评估 Agent 做事情的顺序是否正确,是否选择了正确的方法和工具。
比如一个退款 Agent,最后虽然成功完成退款,但如果它没有查询退款政策,也没有经过必要的审批,那么从最终结果来看任务完成了,但从企业业务流程来看,它依然是不合格的。
第二,需要检查 Agent 在处理事情的过程中是否发生越权、安全或者隐私问题。
比如它是否访问了本不应该访问的数据,是否调用了没有权限的工具,是否绕过了审批流程,甚至是否因为系统漏洞获取了其他敏感数据。
第三,有了新模型之后,可以重新运行同一套 trajectory 和 Eval 数据,评估业务是否适合迁移到新模型。
如何为企业构建高质量 Agent 数据呢?
其实已经有企业在探索了。比如 Snorkel AI,一个核心业务就是帮助客户构建:
specialized training datasets + benchmarks + evaluations + runnable environments,而且已经明确面向 Agents。
在这个过程中,从搭建虚拟环境,到制作评测集,再到具体评估,逐渐形成了一套完整闭环。
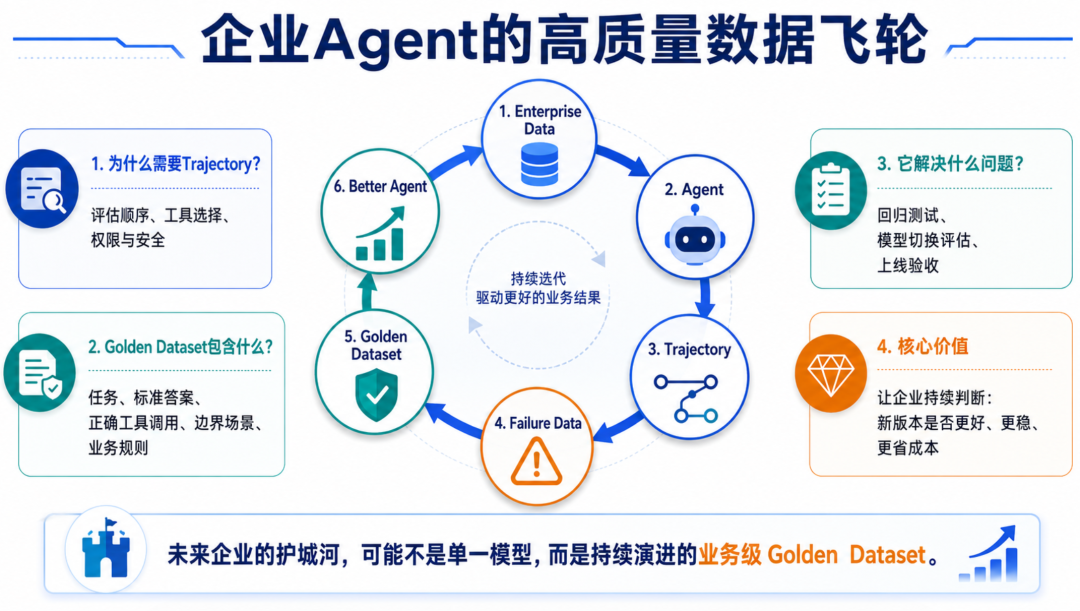
基于这套评估闭环,企业智能体可以形成一个数据飞轮:
Enterprise Data
→ Agent
→ Trajectory
→ Failure Data
→ Better Dataset
→ Better Agent
也就是说,Agent 每一次执行都会产生新的 trajectory;失败的 trajectory 可以转化为新的测试案例和 Golden Data;新的 Golden Data 又可以用来评估下一版 Agent,甚至进一步转化成新的训练数据。
这个过程最终会形成:
Data → Model → Data → Model
的持续迭代。
同时,随着模型能力快速提升,Snorkel 也提出了一个很值得关注的判断:
Agent 的构建能力正在超过人类构建评测数据和 benchmark 的速度,瓶颈开始逐渐出现在 Eval Data 上。
从传统机器学习,到企业 Agent,高质量数据越来越重要。
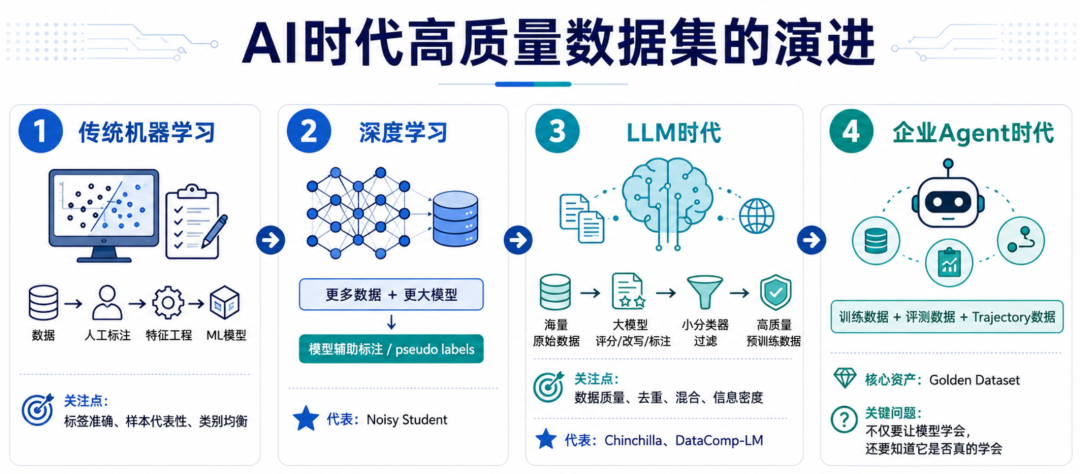
传统机器学习时代,高质量数据主要解决的是:
“模型怎么学?”
而到了企业 Agent 时代,高质量数据还必须解决另一个问题:
“我们怎么知道模型真的学会了?”
模型、Prompt、工具甚至 Agent Framework 都可能发生变化,但只要企业拥有稳定的业务评测标准,就能够持续判断不同 Agent 版本的能力、风险和成本。
从这个角度看,Golden Dataset 很可能成为企业 AI 系统长期业务质量保障的重要基础设施。