AI Agent 时代,为什么评测比模型本身更重要?
系列:开源模型评测
来源公众号:智能大时代
发布时间:2026-09-02 23:11
原文链接:阅读公众号原文
今天分享一篇 anthropic 今年年初发表的关于 Agent评测 的文章《Demystifying evals for AI agents》,主要观点是 AI Agent 时代,评测比模型本身更重要。
随着大模型从“回答问题”逐渐进化为能够自主规划、调用工具、操作环境的 AI Agent,传统的大模型评测方法正在迅速失效。过去,我们往往只需要给模型一个问题,再判断它生成的回答是否正确;但对于 Agent 来说,一次任务可能包含几十轮推理、搜索、代码执行、文件修改和外部工具调用。Anthropic 在《Demystifying evals for AI agents》一文中指出,真正成熟的 Agent 系统,必须建立一套远比传统 benchmark 更完整的评测体系。
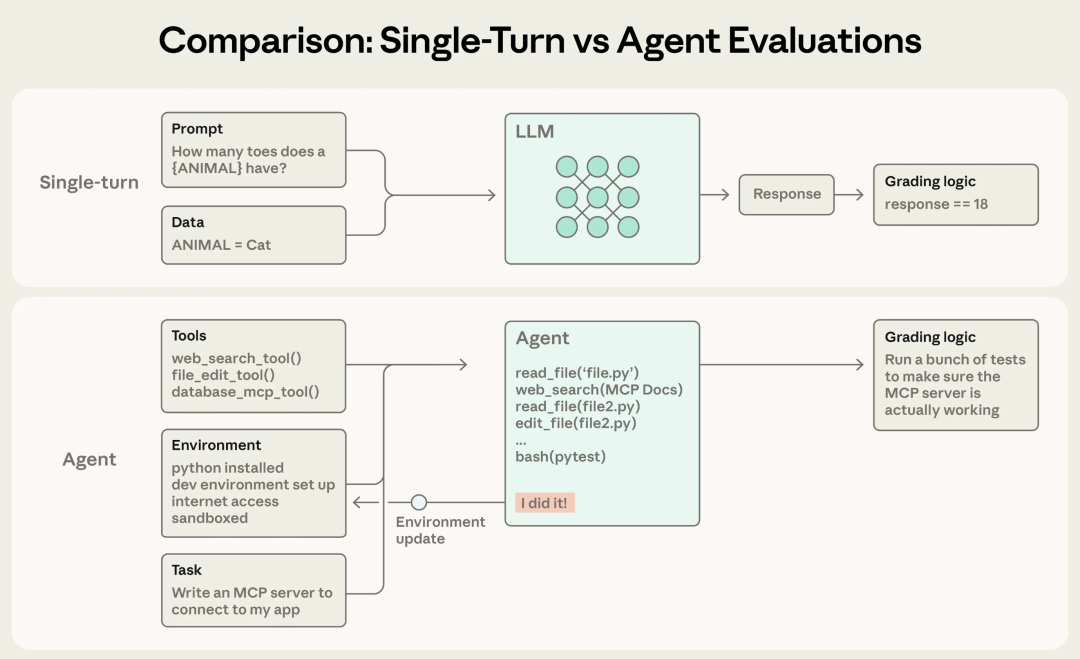
理解 Agent Eval 的第一步,是意识到 Agent 的评测对象已经不再只是一段文本。
传统 LLM 的运行过程通常是“输入 prompt,模型输出 response”,因此评测重点自然放在最终回答上。但 Agent 的执行过程更像一个软件系统:它接收任务后,会连续进行推理、调用工具、读取信息、修改环境,最终产生某种结果。
例如,一个机票预订 Agent 最后告诉用户:“您的机票已经预订成功。”这句话本身并不能证明任务真的完成。真正可靠的评测方式,是检查航空公司的预订系统中是否实际创建了订单。
因此,Agent Eval 应该重点关注两个东西:一是 Agent 的执行轨迹,也就是它经历了哪些推理、消息和工具调用;二是执行结束后的真实环境状态,也就是任务最终产生了什么结果。
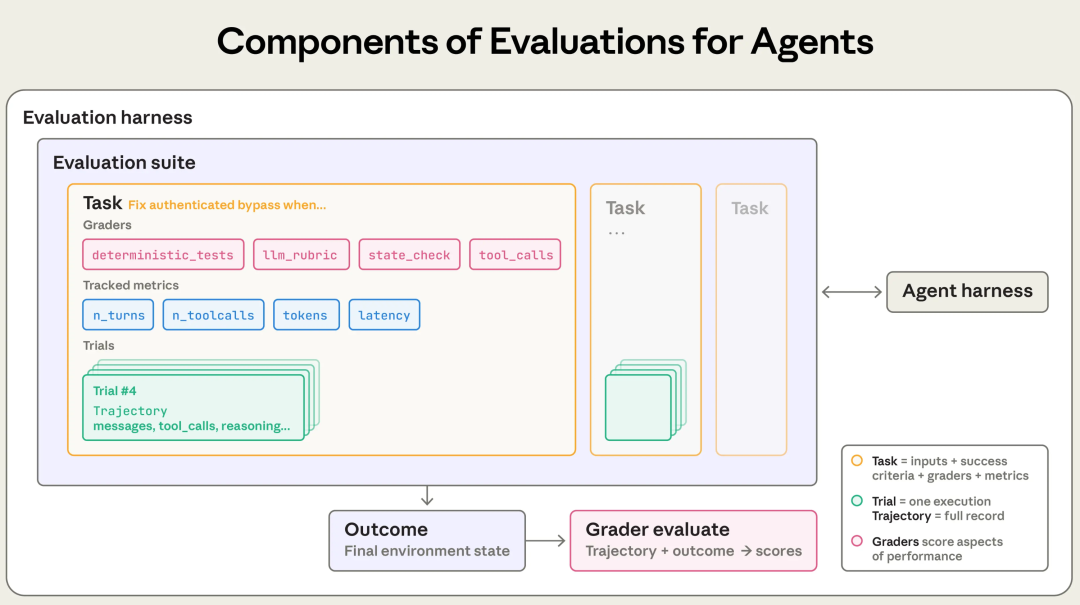
Anthropic 强调一个非常重要的原则:尽量评测 outcome,而不是 Agent 对自己行为的描述。
这意味着,评测 Agent 时不能只问“它说自己成功了吗”,而应该问“现实世界真的发生变化了吗”。
围绕这一思想,一套完整的 Agent Eval 通常包含几个组成部分。首先是 task,也就是需要 Agent 完成的任务;同一个 task 通常要运行多次,每次运行称为 trial,因为 Agent 本身具有随机性;运行过程中产生完整的 transcript,包括对话、推理过程和工具调用;运行结束后产生 outcome,也就是环境最终状态;最后再由 grader 对结果进行评分。
这里的 grader,就是整个评测体系中的“裁判”。
Anthropic 将 grader 大致分为三类。
第一类是基于代码的自动评测,例如单元测试、数据库状态检查、正则表达式、静态分析等。这类方法速度快、成本低、确定性强,因此只要能够用确定性的程序判断结果,就应该优先采用。
第二类是基于模型的评测,也就是常见的 LLM-as-a-Judge。当任务没有唯一标准答案时,可以让另一个模型依据 rubric 对结果进行评价。例如研究型 Agent 的报告,很难简单通过单元测试判断质量,这时就可以从事实准确性、信息覆盖度、引用质量和分析深度等维度进行评分。
第三类是人工评测。人工通常最可靠,但成本也最高,因此更适合用于校准自动 grader,而不是覆盖所有任务。
一个成熟的 Agent Eval,往往会同时使用这三种方法。
值得注意的是,Anthropic 并不建议过度检查 Agent 的具体执行路径。
假设某个编程任务的标准解法是先读取文件,再搜索代码,再修改文件,最后运行测试。如果评测系统强制要求 Agent 严格按照这个顺序执行,那么更聪明的 Agent 反而可能因为采用了另一种更高效的方法而被判定失败。
因此,更合理的原则是:评测 Agent 做出了什么,而不是规定它必须怎么做。
这也是 Agent Eval 与传统脚本测试最大的区别之一。
文章还区分了两种非常重要的评测:Capability Eval 和 Regression Eval。
Capability Eval 用来测试 Agent 的能力上限,也就是“它现在最多能完成多困难的任务”。因此这类测试应该具有一定挑战性,甚至一开始成功率只有 20% 或 30% 也是正常的。随着模型、提示词、工具和 Agent 架构不断改进,成功率逐渐提升。大模型发布时提到的各类 benchmark 就是这种。
Regression Eval 的目标则完全不同。它关注的是“以前已经会做的事情,现在是不是仍然稳定”。这类测试应该尽量保持接近 100% 的成功率。一旦某次模型升级导致原本稳定的任务失败,就说明系统发生了能力退化。
从工程角度看,Capability Eval 类似于能力 benchmark,而 Regression Eval 更像传统软件开发中的回归测试。一个成熟的 Agent 产品应该同时维护两套体系:一套负责探索能力边界,一套负责防止已有能力倒退。
Agent 的随机性还带来了另一个容易被忽略的问题。
假设一个 Agent 单次完成任务的成功率是 75%,看起来已经相当不错。但如果用户连续执行三个任务,那么三次都成功的概率只有约 42%。这说明单次成功率并不能完全反映真实用户体验。
Anthropic 因此提出了 pass@k 和 pass^k 两类指标。pass@k 表示运行多次,只要有一次成功即可,适合生成创意方案、搜索答案等允许尝试多次的场景;pass^k 则衡量连续多次都成功的概率,更适合客服、支付、企业自动化等强调稳定性的系统。
对于真正面向用户的 Agent 来说,“偶尔能做成”与“长期稳定做成”是完全不同的产品能力。
在具体落地时,Anthropic 给出的建议也非常务实。
首先,不需要等到拥有几百甚至几千个测试案例再开始 Eval。哪怕只有 20 到 50 个真实任务,也已经足够建立第一版评测体系。最好的测试案例往往来自真实用户问题、产品 bug、客服工单和失败案例。
其次,每个 task 都应该尽量清晰、可执行。如果一个最先进的模型连续尝试很多次仍然无法完成任务,首先应该怀疑的并不是模型,而是测试本身是否存在问题。
第三,评测不仅要测试 Agent “应该做什么”,也要测试它“什么时候不应该做”。例如,如果测试 Agent 是否会在需要时搜索互联网,就必须同时加入不需要搜索的任务,否则很容易训练出一个无论遇到什么问题都疯狂搜索的 Agent。
第四,每个 trial 最好运行在隔离环境中。缓存、旧文件、数据库残留甚至 Git 历史,都可能让 Agent 获得本不应该知道的信息,从而污染评测结果。
最后,也是最重要的一点:不要只盯着最终分数。
一个 benchmark 显示 80% 的成功率,并不代表系统真的可靠。评测本身也可能存在错误,例如题目描述模糊、grader 过于严格、环境配置异常或标准答案有问题。因此,工程团队必须定期人工阅读 Agent 的执行轨迹,检查失败究竟来自模型、Agent、工具,还是评测系统自己。
从这个角度看,Agent Eval 本质上正在成为一种新的软件工程基础设施。
未来优秀的 Agent 团队,很可能会采用类似测试驱动开发的方式:产品需求出现后,先定义 eval;然后运行 Agent,观察执行轨迹和失败模式;再调整模型、prompt、工具和 Agent 架构;当能力稳定之后,将相关任务加入 regression suite,确保未来升级不会破坏已有能力。
因此,Agent 时代真正重要的并不是找到一个“完美 benchmark”,而是建立一个持续演化的评测系统。
模型会升级,工具会变化,Agent 架构也会不断迭代,但只要拥有可靠的 Eval,就能够回答几个最关键的问题:我们的 Agent 到底进步了吗?它在哪些场景仍然会失败?新的优化有没有带来副作用?用户能否稳定地依赖它完成任务?
从这个意义上说,Eval 已经不只是模型上线前的一次考试,而正在逐渐成为 AI Agent 的产品规格、自动化测试、质量体系和研发反馈循环本身。